Embeddings: Come Insegnare alle Macchine a Capire le Parole
Perché servono gli Embeddings?
Gli esseri umani sono bravissimi a capire il significato delle parole.
Se ti dico:
- “Pallone”
- “Calcio”
- “Tifoso” tu capisci subito che c’entra lo sport.
Se dico:
- “Forno”
- “Farina”
- “Impasto”
capisci che si parla di cucina. 💡 Le macchine però vedono solo numeri.
Serve quindi un modo per trasformare le parole in qualcosa di numerico, ma che mantenga il loro significato.
Gli embedding sono proprio questo:
coordinate nello spazio che rappresentano il significato delle parole.
Immagina un Google Maps del linguaggio: ogni parola ha una posizione, e parole simili stanno vicine.
Bag of Words: la prima idea (carina ma ingenua)
Cos’è Bag of Words? 🧺
È il modo più semplice per trasformare un testo in numeri:
-
si prendono tutte le parole presenti nei testi,
-
si crea un gigantesco “vocabolario”,
-
ogni frase viene convertita in un vettore di lunghezza numero parole totali,
-
in ogni posizione si mette quante volte quella parola compare.
Esempio
Supponiamo tre frasi:
-
Il gatto mangia il pesce
-
Il cane mangia la carne
-
Il gatto e il cane giocano
Vocabolario (ordine inventato):
| Parola | 1 | 2 | 3 |
|---|---|---|---|
| il | 2 | 2 | 1 |
| gatto | 1 | 0 | 1 |
| cane | 0 | 1 | 1 |
| mangia | 1 | 1 | 0 |
| pesce | 1 | 0 | 0 |
| carne | 0 | 1 | 0 |
| giocano | 0 | 0 | 1 |
| e | 0 | 0 | 1 |
Vantaggi di Bag of Words
-
Semplice da capire.
-
Facile da implementare (anche in prima liceo).
Limiti di Bag of Words
-
Vettori enormi (migliaia di parole = migliaia di numeri).
-
Non cattura il significato:
per Bag of Words “gatto” e “leopardo” sono totalmente diversi. -
Parole molto frequenti (il, di, e) dominano tutto.
-
Non capisce il contesto:
“pesca” (verbo) e “pesca” (frutto) vengono confuse.
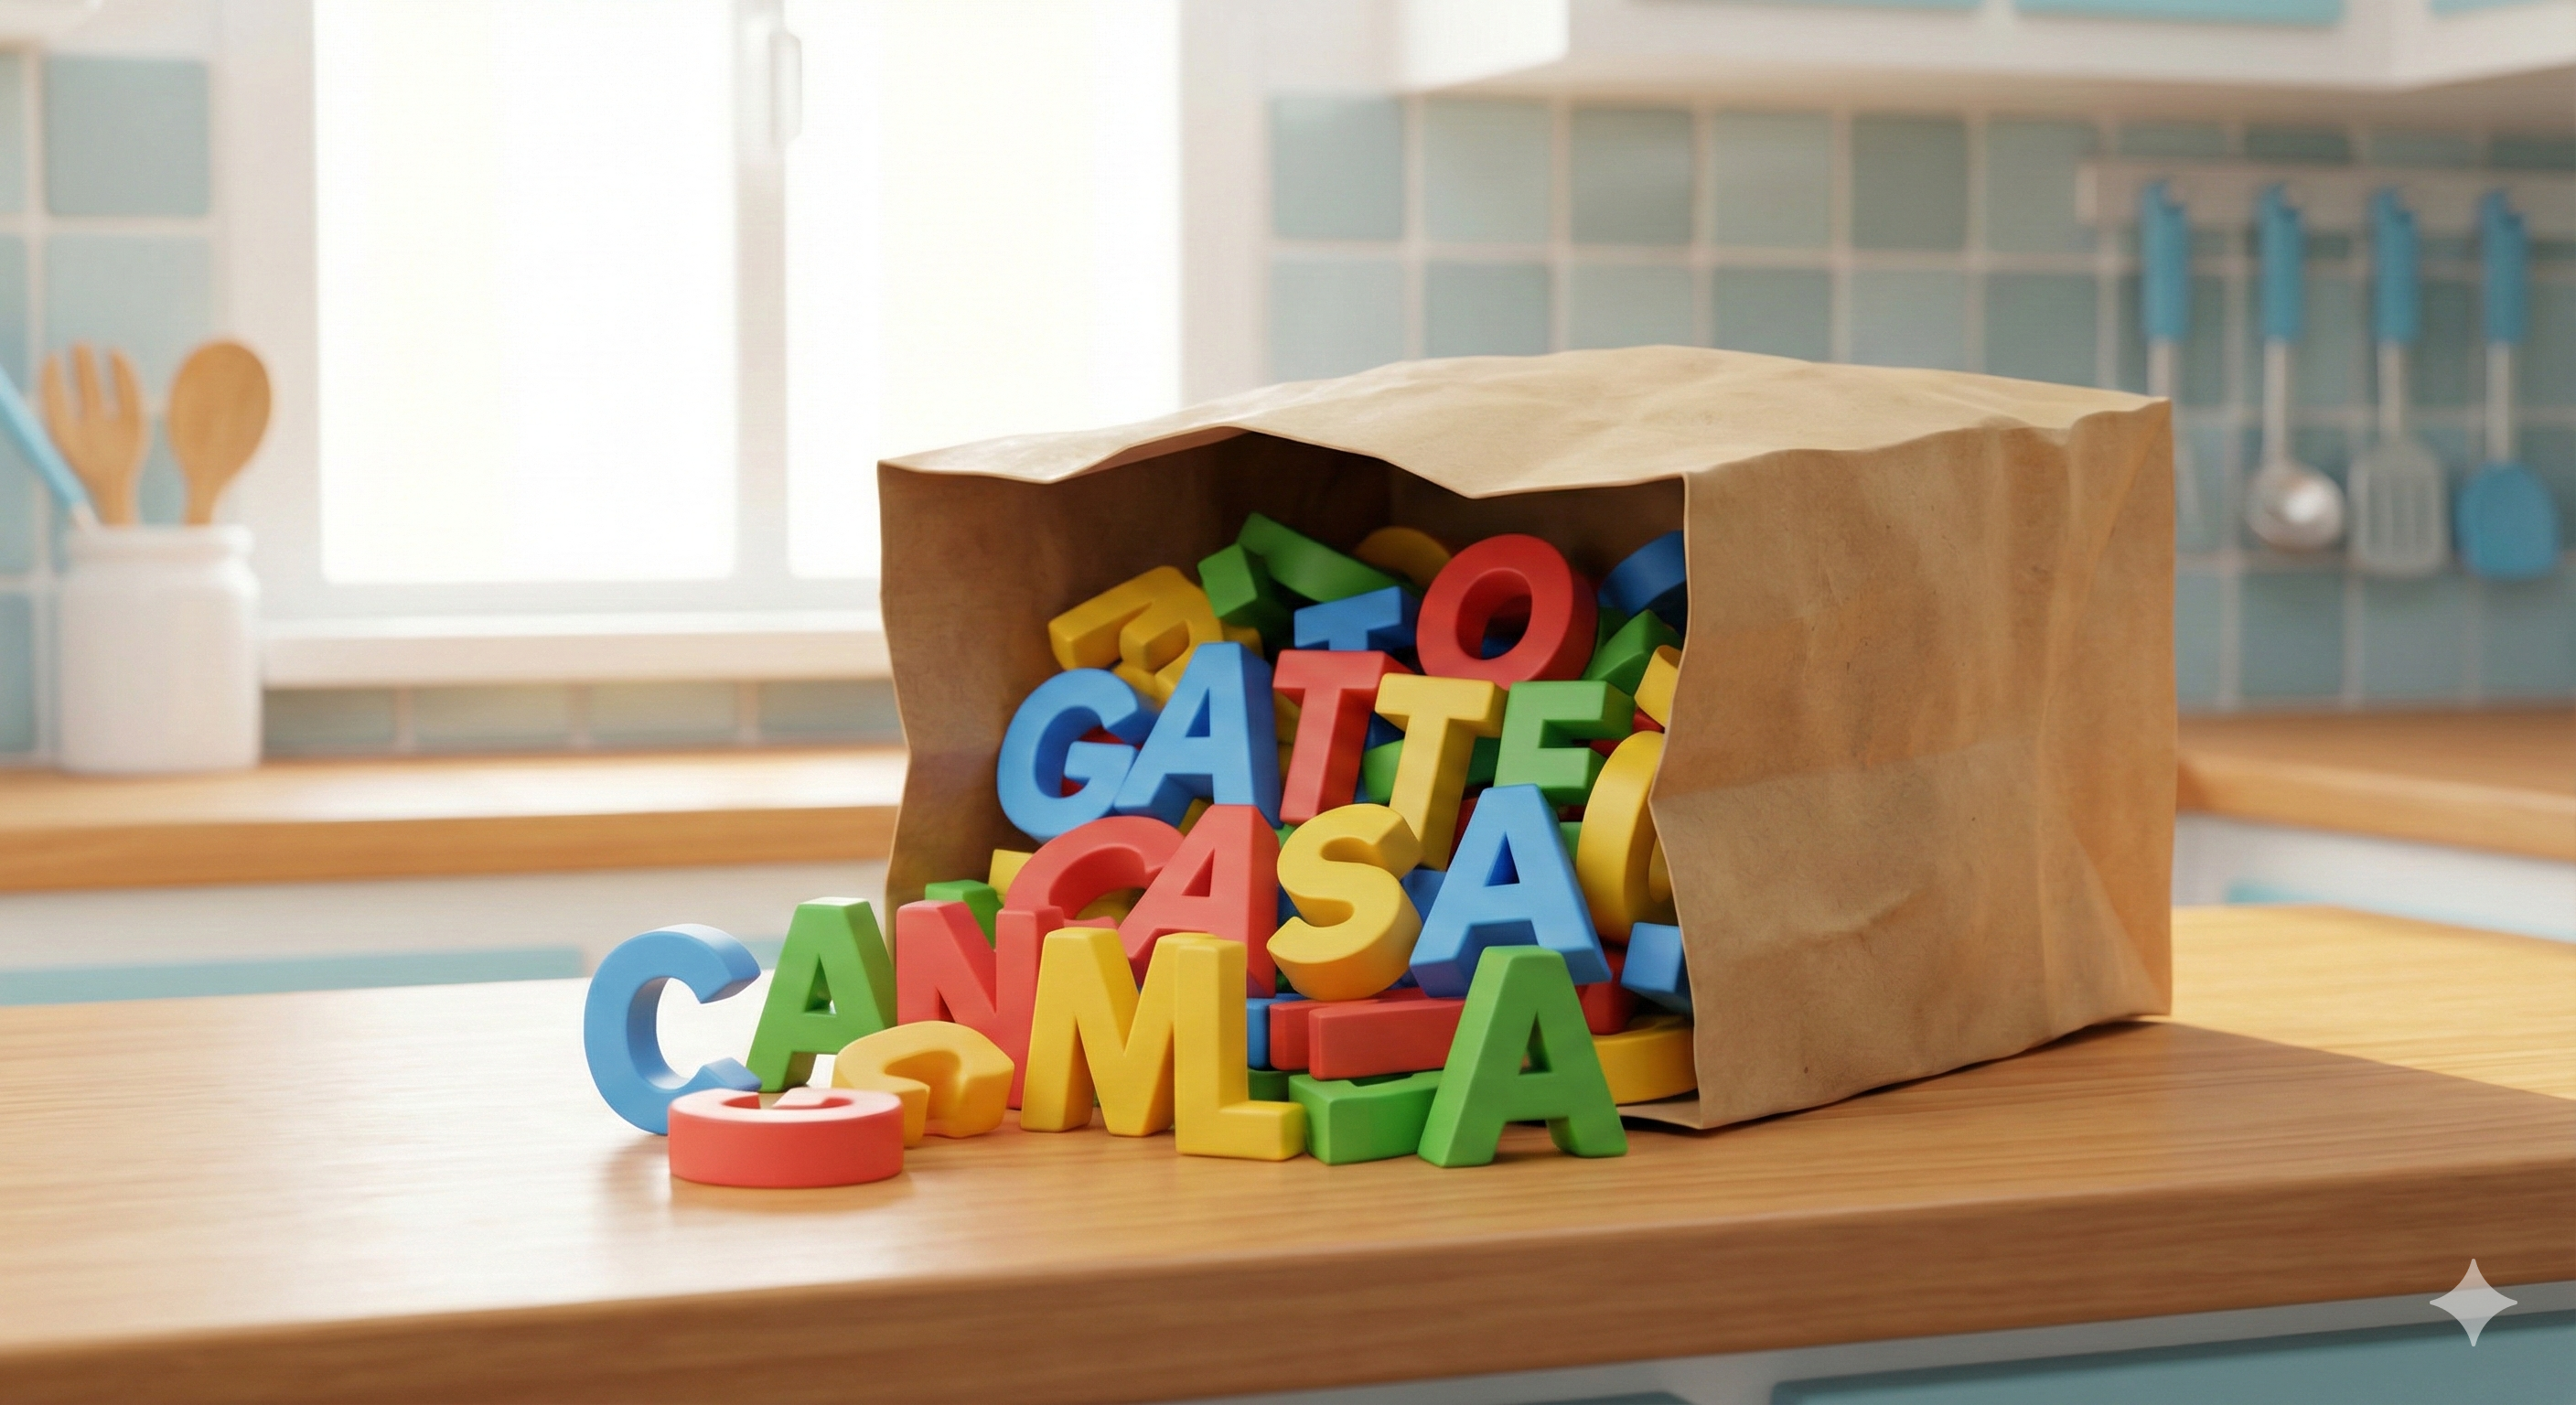
È come prendere una frase, scrivere ogni parola su dei foglietti, appallottolarli e buttarli in un sacchetto. Poi scuotete il sacchetto. Cosa è rimasto? Il conteggio.
Nel metodo Bag of Words (BoW), al computer non importa l’ordine delle parole o la grammatica. Gli importa solo quante volte compare una parola
Di conseguenza, frasi come Il gatto mangia il pesce o il pesce mangia il gatto risultano semanticamente identiche per questo sistema ‼️
TF-IDF: Bag of Words diventa più intelligente
Dopo un po’, ci si è accorti che contare e basta non funziona. Perché?
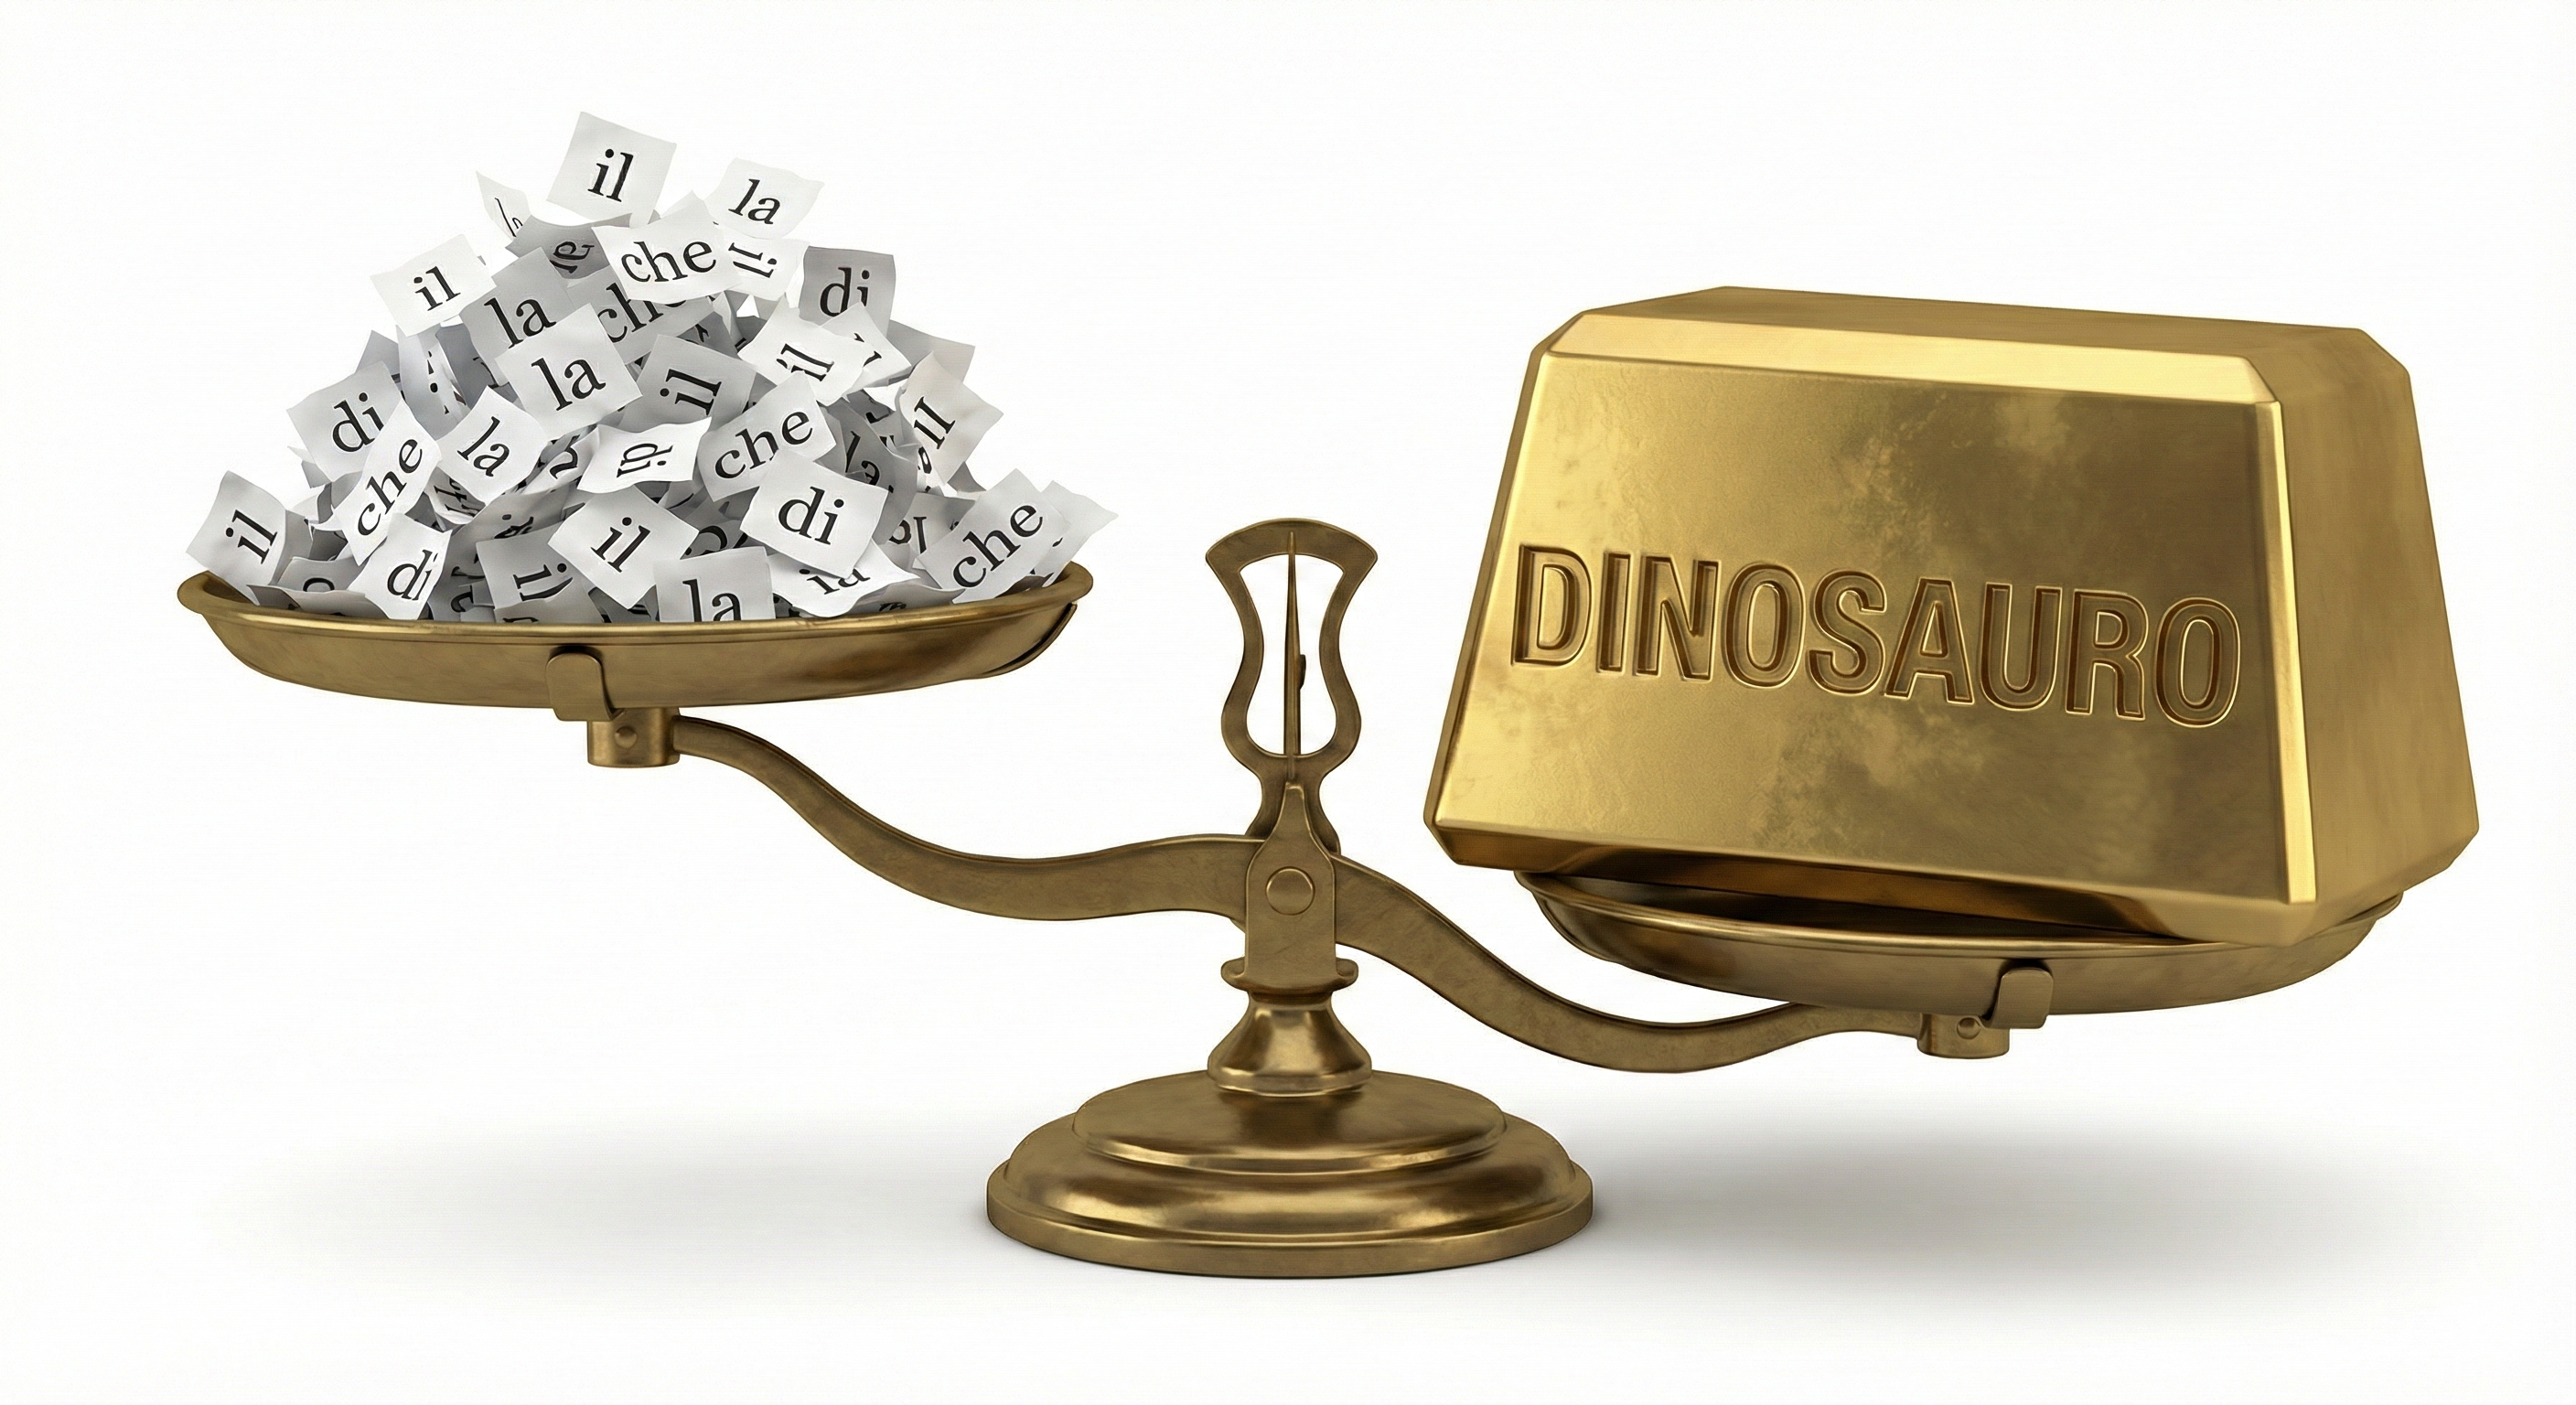
Perché parole come “il”, “è”, “di”, “a” compaiono ovunque ma non significano niente (si chiamano Stopwords). Mentre parole come “Rinoceronte” o “Ferrari” sono rare ma molto importanti per capire l’argomento.
Ecco TF-IDF (Term Frequency - Inverse Document Frequency). Sembra uno scioglilingua, ma è semplice:
La logica: “Se una parola appare spesso in QUESTA frase, ma raramente nelle ALTRE frasi, allora è una parola VIP ⭐”.
- TF (Frequenza): Conta quanto la parola è presente qui.
- IDF (Rarità): Penalizza le parole che usano tutti (come “il”).
TF-IDF = TF × IDF
Effetto pratico
-
Parole come “il”, “la”, “di” ottengono punteggi bassissimi perché sono generalmente molto presenti.
-
Parole come “pesce”, “carne”, “giocano” diventano molto informative se presenti in una frase.
Vantaggi di TF-IDF
-
Riduce l’importanza delle parole inutili.
-
Buono per motori di ricerca “classici” perchè capisce quali sono le parole chiave (“Keyword extraction”)
Limiti di TF-IDF
-
Ancora vettori enormi (dimensione = vocabolario).
-
Nessun vero “significato”:
“gatto” e “tigre” restano completamente slegati. -
Non cattura sinonimi. “Auto” e “Macchina” sono due parole diverse.
-
Non capisce il contesto.
Word2Vec: rivoluzione! Le parole diventano coordinate piene di significato
Nel 2013 Google introduce Word2Vec: una delle svolte epocali del NLP.
Idea:
Invece di contare parole, cerchiamo di capire dove compaiono.
Come funziona 🧠
Il modello guarda frasi reali e impara che:
-
“gatto” appare vicino a “mangiare”, “miagolare”, “felino”.
-
“cane” appare vicino a “abbaiare”, “giocare”, “collare”.
Risultato:
le parole vengono rappresentate come vettori di 50–300 numeri, non più lunghissimi come accadeva in TF-IDF.
Immagina un GPS semantico:
| Parola | Coord1 | Coord2 | Coord3 | … |
|---|---|---|---|---|
| gatto | 0.12 | -0.44 | 0.88 | … |
| cane | 0.10 | -0.47 | 0.90 | … |
| pesce | -0.33 | 0.05 | 0.11 | … |
Proprietà magiche 🚀
Word2Vec cattura relazioni semantiche sorprendenti:
Re - Uomo + Donna = Regina
Parigi - Francia + Italia = Roma
Camminare - Piede + Ruota = Guidare (a volte)
Vantaggi di Word2Vec
-
I vettori sono compatti (100–300 dimensioni invece che 10.000).
-
Cattura somiglianze e relazioni semantiche.
-
Enorme salto rispetto a TF-IDF.
Limiti di Word2Vec
-
Non capisce il contesto.
“pesca” = stessa parola → stesso vettore
che parli di frutto o dell’attività… -
Un vettore per parola per sempre.
Nessuna personalizzazione per la frase. -
Dipendenza dal dataset di origine.
Se Word2Vec è addestrato su Wikipedia, non capirà bene slang tipo “bro”, “cringe”, “sus”.
(Il modello diventa boomer.)
La similarità tra parole: come si misura?
Come facciamo a sapere se due parole sono simili?
Per confrontare due vettori di embedding si usa la cosine similarity.
Non guarda la distanza assoluta tra le due parole, ma l’angolo che le divide.
Intuizione geometrica
-
Due parole simili puntano nella stessa direzione → angolo piccolo → similarità alta.
-
Parole diverse puntano in direzioni molto diverse → angolo grande → similarità bassa.
Valori:
-
1.0 → identici
-
0.6 → abbastanza simili
-
0.0 → neutri
-
-1.0 → opposti (rarissimo per il linguaggio)

Il trucco del “Re - Uomo + Donna” 🎩 Word2Vec permette di fare Algebra con le parole.
Se prendi il vettore del RE, sottrai il concetto di UOMO e aggiungi il concetto di DONNA… atterri esattamente sulle coordinate della REGINA.
BERT e oltre: gli embedding “contestuali”
Word2Vec è geniale, ma ha un difetto enorme:
Ogni parola ha un solo significato numerico.
Ma noi esseri umani non funzioniamo così.
Esempio:
-
“Ho un piano per rapinare la banca” → programma
-
“Raggiungimi al terzo piano” → livello
-
“Vali più piano, mi viene da vomitare” → intensità
Serve un modello che capisca il contesto.
Ed ecco che arrivano i Transformer.
BERT (2018): il game changer
BERT (Bidirectional Encoder Representations from Transformers) non crea un vettore solo per la parola, ma un vettore diverso per ogni frase.
Esempio:
- embedding(“piano”, frase1) ≠ embedding(“piano”, frase2) ≠ embedding(“piano”, frase3)
🔎Ancora:
- Frase A: “Mi siedo sulla panchina del parco.”
- Frase B: “La panchina dell’Inter è molto lunga.”
Perché il sistema guarda tutta la frase contemporaneamente usando self-attention.
Vantaggi di BERT
-
Coglie il contesto.
-
Capisce polisemia (parole con più significati).
-
Embedding molto più ricchi e precisi.
-
Ottimi per ricerca semantica, chatbot, classificazione, RAG.
Limiti di BERT
-
Più lento e pesante rispetto a Word2Vec.
-
Richiede GPU per essere addestrato.
-
Non sempre “lineare” da interpretare.
Oggi: Embedding moderni (anche per LLM)
Modelli come:
-
Sentence-BERT
-
E5
-
BGE
-
Gemma Embeddings
-
OpenAI Embeddings
producono vettori per intere frasi, non solo parole.
Cosa cambia?
-
Mantengono il contesto.
-
Capiscono sinonimi, parafrasi, frasi equivalenti.
-
Sono ottimi per RAG (Retrieval Augmented Generation).
Esempio:
Frase cercata:
“strumento per tagliare l’erba!”
Documenti:
-
“manuale del robottino da giardino”
-
“guida al giardinaggio”
-
“storia della musica classica”
Gli embedding:
-
avvicinano la frase al “robottino” o al “giardinaggio”
-
mettono lontanissimo “musica classica”